OpenAI、Google 與 Microsoft 在 2026 年 10 月 30 日同步宣布,支持由 Anthropic 工程師主導起草的 robots.txt 新標準:只要在網站設定檔中加入一個統一識別符號,就能同時向四大 AI 公司表達「不同意使用本站內容訓練 AI 模型」的立場。這是 AI 產業有史以來,主要競爭對手第一次共同承諾遵守同一份內容授權規則。根據台灣公平交易委員會 2026 年 10 月 29 日公布的調查,超過五成台灣成年人已在使用生成式 AI 工具,ChatGPT 與 Google Gemini 合計使用率超過九成。對台灣企業而言,這是第一次可以用一個簡單設定,主動選擇網站內容是否加入 AI 訓練。
這份協議是什麼?四大 AI 公司為何要達成共識?
過去想阻止 AI 公司使用你的網站內容進行模型訓練,需要在 robots.txt 裡分別列出每家公司的爬蟲名稱。封鎖 OpenAI 要寫 GPTBot、封鎖 Google 的 AI 訓練要寫 Google-Extended、封鎖 Anthropic 要寫 ClaudeBot,每家公司規則各不相同,爬蟲名稱也可能隨時更新。對中小企業來說,幾乎沒有人力可以持續追蹤這些變化。
2026 年 10 月 30 日,Anthropic 工程師 Kevin Kelley 在 IETF(網際網路工程任務組)正式發布一份網際網路草稿(Internet-Draft),提出統一識別符號 __usage_ai-training。只要在 robots.txt 中加入這個識別符號,所有支持這份標準的 AI 公司都同意遵守,不需要再逐一列出各家爬蟲名稱。OpenAI、Google 和 Microsoft 在同一天宣布將支持這份標準;Anthropic 已率先開始實作。
這四家公司分別代表目前全球使用率最高的生成式 AI 工具:ChatGPT(OpenAI)、Gemini(Google)、Copilot(Microsoft)和 Claude(Anthropic)。在競爭激烈的 AI 產業,四大公司同時公開承諾遵守同一份規則,是相當少見的協作。
什麼是 IETF Internet-Draft
IETF 是制定全球網路技術標準的組織,HTTP、TLS 等基礎協定都從這裡確立。Internet-Draft 是草稿階段文件,尚未成為正式的 RFC 標準,但已有四大公司公開承諾支持。目前這份協議沒有強制法律效力,完全依賴各公司的自願遵守。
只需兩行設定:robots.txt 新語法完整說明
要讓這項設定生效,網站管理員只需要在 robots.txt 加入以下兩行:
第一行 User-Agent: __usage_ai-training,是統一識別符號,告訴所有支持標準的 AI 訓練爬蟲「以下規則是針對你」;第二行 Disallow: /,代表拒絕全站內容用於訓練。如果只想保護特定目錄,例如保護部落格文章但讓首頁和產品頁繼續被訓練,可以改為指定路徑:User-Agent: __usage_ai-training 搭配 Disallow: /blog/。
在操作之前,有幾個細節要注意:
- 萬用字元不適用:robots.txt 裡常見的 `User-Agent: *`(代表所有爬蟲)並不涵蓋這個識別符號,必須明確寫出 `__usage_ai-training` 才有效。
- 不寫不等於同意,也不等於拒絕:如果 robots.txt 裡沒有這段設定,代表「沒有明確表達意見」,各 AI 公司仍按原本規則處理你的內容。
- 只影響未來訓練:加入設定只能阻止未來的資料收集,已被納入訓練集的內容不會被刪除。
| robots.txt 設定方式 | 效果說明 |
|---|---|
| User-Agent: __usage_ai-training + Disallow: / | 全站內容退出 AI 訓練 |
| User-Agent: __usage_ai-training + 指定目錄路徑 | 特定目錄退出 AI 訓練 |
| 沒有這段設定(省略) | 沒有表達意見,各公司維持原本判斷 |
| User-Agent: * + Disallow: / | 封鎖所有爬蟲(不同效果,詳見下文) |
四家公司的實施時程分別是什麼?
各家公司承諾的時間點不一,整理如下:
| AI 公司 | 承諾實施時間 | 補充說明 |
|---|---|---|
| Anthropic(Claude) | 已開始實作 | 草稿起草公司,最早執行 |
| OpenAI(ChatGPT) | 未來數個月內 | 支持意願已公告,確切日期未定 |
| Microsoft(Copilot) | 2027 年 2 月 1 日 | 目前唯一有明確截止日期的承諾 |
| Google(Gemini) | 2027 年(日期未定) | 退出效果等同設定 Google-Extended 為 Disallow |
Microsoft 另外宣布,2027 年 3 月 1 日起,舊有的 NoArchive 與 NoCache 設定標籤將停用。如果你的網站原本有這些舊設定,需要在 2027 年 3 月前更新。
目前唯一明確的截止日期
Microsoft 的實施日期是 2027 年 2 月 1 日,是四家公司中唯一有明確時間節點的承諾。如果你已決定退出 Microsoft Copilot 的訓練用途,應在 2027 年 2 月 1 日前完成 robots.txt 設定。
退出 AI 訓練和封鎖爬蟲,是截然不同的兩件事
這是理解這份標準最關鍵的一點,也是台灣企業最容易搞混的觀念。
退出 AI 訓練(Training opt-out),也就是本文討論的 __usage_ai-training 標準,控制的是 AI 公司如何「使用」你的網站內容。加入設定後,支持標準的 AI 公司承諾不把你的網頁內容加入未來的訓練資料集。但他們的爬蟲程式仍然可以正常拜訪你的網站、讀取你的頁面,也仍然有可能在生成式 AI 的回答中引用你的品牌。
封鎖爬蟲(Blocking crawlers),也就是傳統 robots.txt 設定中的 `User-Agent: GPTBot` 加 `Disallow: /`,控制的是 AI 公司是否能「存取」你的頁面。爬蟲被封鎖後,AI 讀不到你的網站,自然不會拿去訓練,但也意味著 AI 完全不知道你的品牌存在,無法在回答中推薦或引用你。
情境示範:一家台灣旅宿業者擔心自己的服務介紹被用於訓練競爭對手的 AI,但同時希望當旅客問「花蓮哪家民宿有好評」時,ChatGPT 和 Gemini 能推薦自己。正確做法是只設定 __usage_ai-training 退出訓練,絕對不要封鎖爬蟲。一旦封鎖了爬蟲,AI 就再也不知道這家民宿的存在,推薦機會歸零。
退出訓練 ≠ 封鎖爬蟲
退出訓練讓 AI 爬蟲照常讀取你的頁面,只是限制用於訓練;封鎖爬蟲則讓 AI 完全看不到你,自然也不會被引用。對大多數台灣企業而言,退出訓練是可以考慮的選項,但封鎖爬蟲幾乎沒有好處。
台灣企業的現況:超過五成國人已在使用生成式 AI
根據台灣公平交易委員會 2026 年 10 月 29 日公布的調查(調查期間 2026 年 5 月 6 日至 28 日,有效樣本 1,079 名 18 歲以上成年人),超過五成台灣成年人在過去半年內使用過生成式 AI 工具。使用率最高的是 ChatGPT(87.9%),其次是 Google Gemini(67.8%),Claude 為 8.9%。此外,近四成使用者已付費訂閱 AI 服務,付費者中約半數每月消費新台幣 500 至 1,000 元。
這兩個工具(ChatGPT 和 Gemini)正好屬於宣布支持新標準的 OpenAI 和 Google。換句話說,你的潛在客戶每天都在問這兩個工具各種問題,從「台灣哪家 AI 顧問公司值得信任」到「餐廳推薦、醫師推薦、建材廠商推薦」,AI 的回答直接影響消費決策。你的網站內容是否進入 AI 訓練資料,長期決定了品牌在 AI 回答中的能見度。
在這個背景下,這份新標準的意義不只是「技術設定」,而是企業第一次有正式管道,主動決定自己的品牌資產與 AI 訓練體系的關係。
退出還是留下?企業決策框架
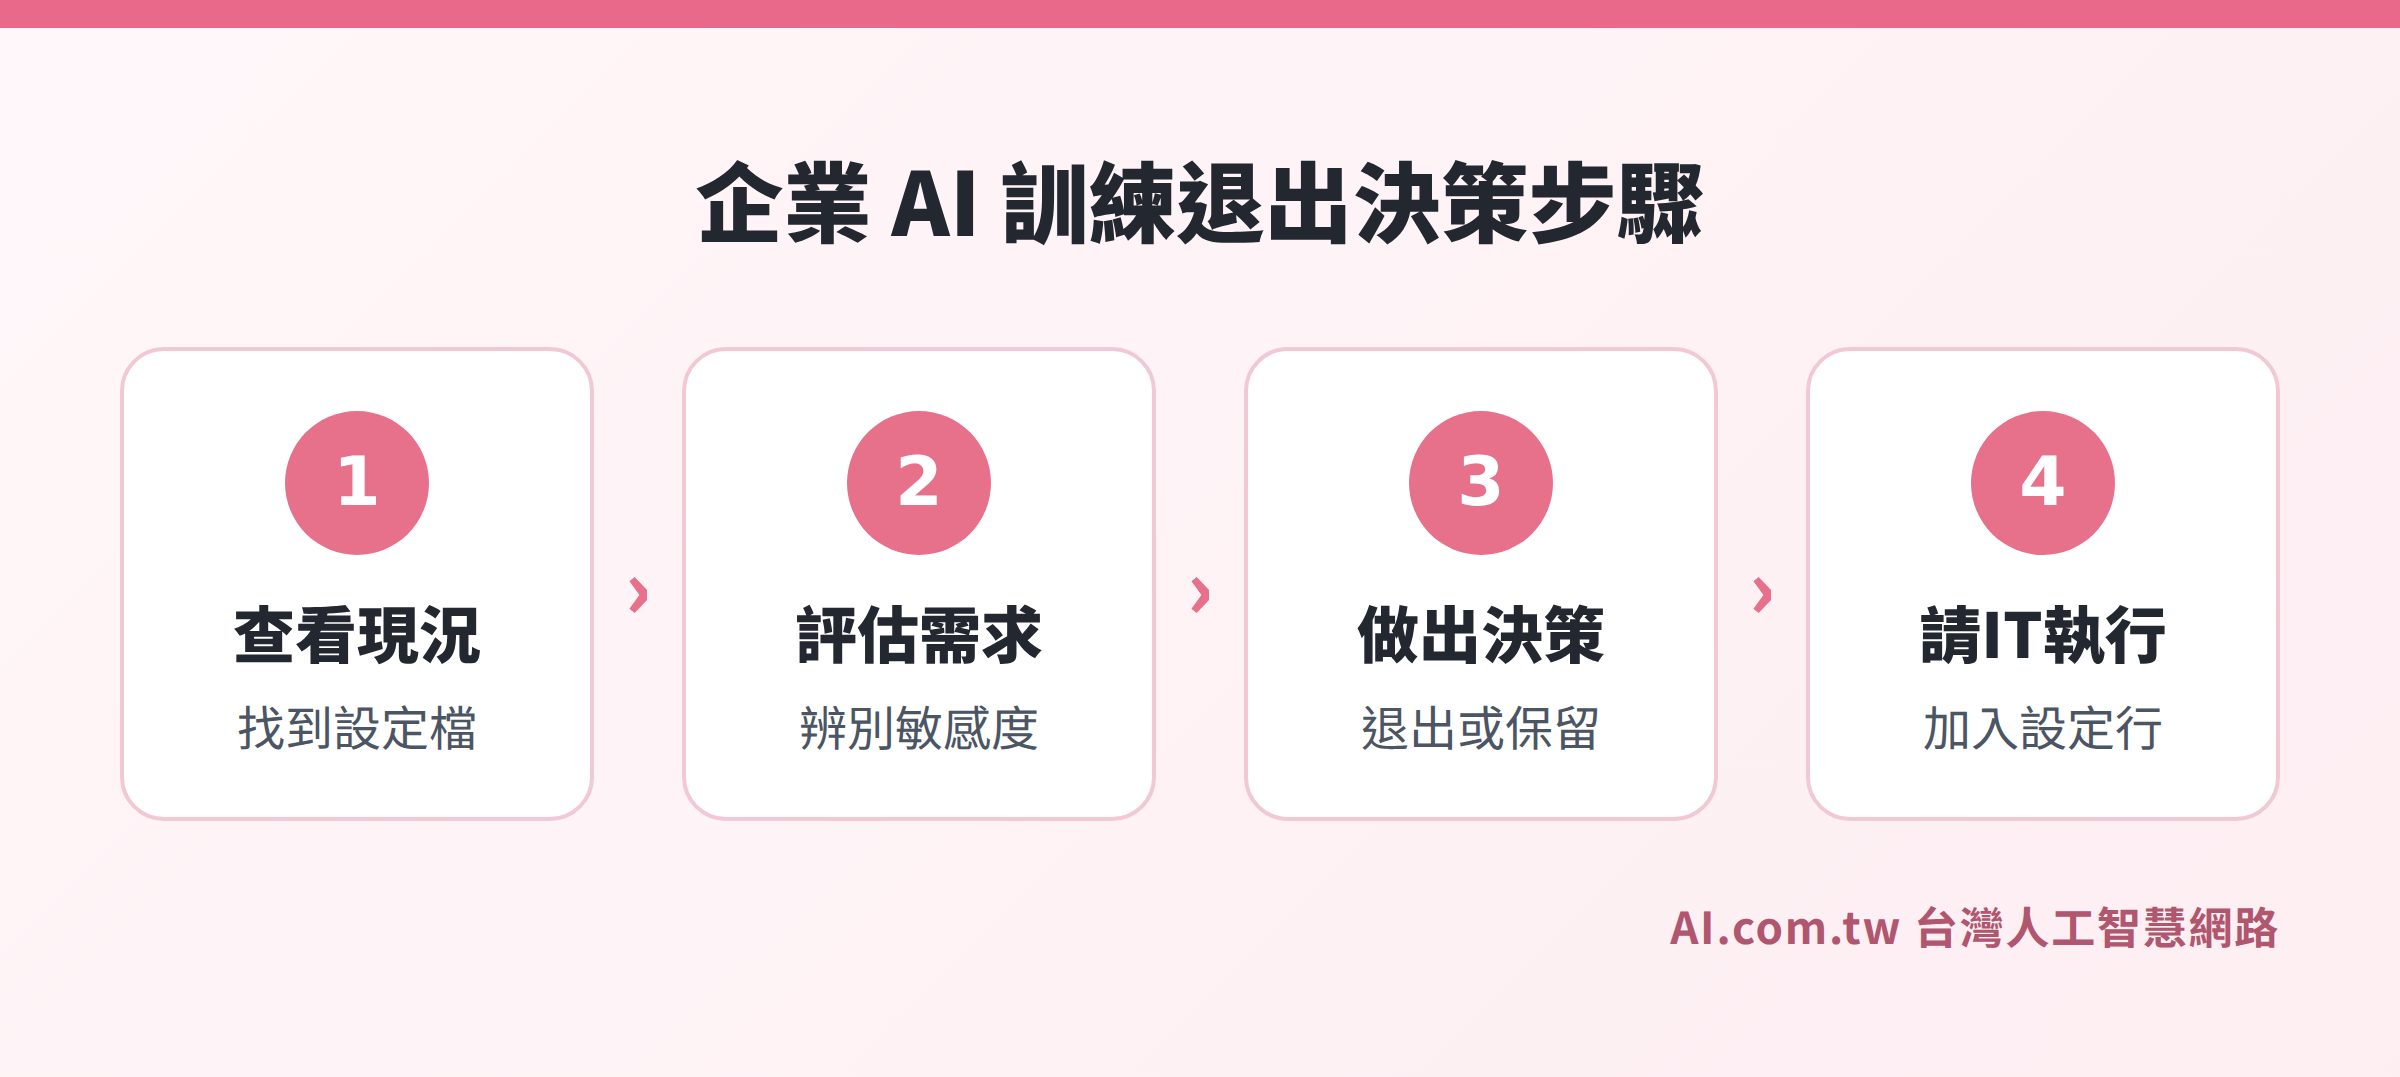
在決定是否退出之前,建議先回答三個問題:
第一,你的網站上有沒有高度機密的內容? 例如完整的業務流程文件、尚未公開的研發成果、特定客戶的合約細節。如果有,可以考慮只針對這些特定目錄設定退出,而非全站退出。
第二,你的業務有多依賴 AI 推薦? 如果目標客群越來越多透過生成式 AI 尋找產品與服務,讓 AI 了解你的品牌就是獲客的一部分。退出訓練不會立刻影響 AI 現有的認識(過去的資料已在訓練集裡),但長期而言,新發布的內容不再進入訓練,品牌在 AI 回答中的存在感會逐漸下降。
第三,是否有資料授權或法律疑慮? 金融、醫療、法律等產業的客戶資料有特定保護要求,如果這類敏感資訊曾以任何形式出現在網站公開頁面,可能需要更謹慎評估。
| 企業類型 | 建議策略 | 主要考量 |
|---|---|---|
| 以品牌曝光為目標的服務業 | 不退出,積極優化 AI 可見度 | AI 推薦是重要獲客來源 |
| 有專有技術文件的製造業 | 只退出敏感目錄,保留其他頁面 | 保護核心知識,同時維持品牌曝光 |
| 法律、財務、醫療相關機構 | 先諮詢法律顧問再決定 | 資料授權疑慮需要專業評估 |
| 電商、零售、餐飲、旅宿 | 不退出,確保內容對 AI 友善 | 消費者用 AI 找商家,退出代價高 |
| 不確定如何決定的中小企業 | 先維持現況,觀察後再決定 | 現階段不設定不會立即影響現有 AI 認知 |
退出訓練後,品牌在生成式 AI 的回答中還看得見嗎?
這是很多企業擔心的問題。依目前已知的技術細節,AI 訓練(Training)與 AI 引用(Grounding)是兩個不同的機制。退出訓練後,你的頁面仍然可以被爬取,理論上仍有機會被 AI 在回答中引用。
然而 Google 已明確說明,設定 __usage_ai-training 退出訓練,效果等同於將 Google-Extended 設為 Disallow。Google-Extended 原本控制的就是 Gemini Apps 等 AI 產品的引用資格,因此退出訓練在 Google 的系統中,可能同時影響到在 Gemini 中被引用的機率。其他公司的細節尚未完整公布,整個標準仍在演進中。
對台灣企業而言,如果目標是被生成式 AI 推薦和引用,目前最有效的做法不是調整 robots.txt 設定,而是主動優化網站內容的結構和可信度,讓 AI 更容易理解和引用你的品牌資訊。這正是 AI-SEO 與生成式引擎優化(GEO) 所要解決的問題。
老闆現在可以怎麼做?五個具體準備步驟
- 查看目前的 robots.txt:在瀏覽器輸入 `https://你的網域/robots.txt`,確認目前有哪些爬蟲設定。了解起點,才能做出有根據的決定。如果你的網站已有 `User-Agent: GPTBot` 或 `User-Agent: Google-Extended`,代表過去已針對特定爬蟲設定限制,可以一並評估是否需要調整為新標準。
- 評估是否有需要保護的敏感內容:列出網站上哪些目錄或頁面包含不希望被 AI 訓練使用的資訊,例如詳細的報價邏輯、獨家教學方法或客戶案例細節。評估完之後,可以決定全站退出還是只針對特定路徑。
- 與法律或資安顧問確認(若有疑慮):如果你的網站屬於金融、醫療或法律相關,或者服務內容涉及客戶的個人資料,在修改設定之前,建議先確認相關的資料使用授權規範。
- 請 IT 或網站管理員執行設定:WordPress 網站可以透過 Yoast SEO 或 Rank Math 等 SEO 外掛的「Tools > File Editor」入口直接編輯 robots.txt,不需要進入主機面板。修改完成後,在瀏覽器輸入網址查看 robots.txt 確認新設定已生效。
- 把這件事納入整體 AI 品牌策略討論:AI 訓練退出不是孤立的技術選項,而是整體品牌在生成式 AI 中的定位策略一部分。如果不確定企業現在在 ChatGPT、Gemini 等工具中的能見度如何,可以先做一次 免費的 AI 企業健診,了解現況與改善方向。
常見問題
現在加上退出設定,過去已在 AI 訓練資料裡的內容會被刪除嗎?
不會。這項標準只影響「未來」的訓練資料收集,已被納入現有訓練資料集的網站內容,不在協議的處理範圍內。四家公司也沒有承諾主動刪除既有資料。加入設定的效果是「從現在起,支持標準的 AI 公司不再把我的新內容用於訓練」,而不是把所有資料從訓練集中清除。
robots.txt 裡的 User-Agent: * 萬用字元有沒有包含這個效果?
沒有。根據標準草稿說明,萬用符號群組(User-Agent: *)並不適用於 __usage_ai-training 識別符號的判斷。即使你的 robots.txt 已有 `User-Agent: * Disallow: /`(封鎖所有爬蟲),也無法替代這段退出訓練的設定,因為兩者是完全不同的機制。想讓 AI 訓練退出生效,必須明確寫出 `User-Agent: __usage_ai-training`。
退出訓練設定後,Google Gemini 還會在回答中引用我的網站嗎?
這是目前最大的不確定因素。Google 表示,設定 __usage_ai-training 退出的效果等同於將 Google-Extended 設為 Disallow,而 Google-Extended 與 Gemini Apps 等產品的引用資格有關,因此退出訓練可能同時降低在 Google AI 產品中被引用的機率。其他公司(OpenAI、Microsoft)的具體細節尚未完整說明。建議在做決定之前,先確認最新的官方說明,或諮詢了解 AI 可見度策略的顧問。
如果其他 AI 公司不遵守這項標準,設定還有用嗎?
有限。這份標準目前只有 OpenAI、Google、Microsoft、Anthropic 四家公司公開承諾遵守,其他 AI 公司(例如各國較小的模型廠商或開源訓練者)不在範圍內。此外,這份協議沒有強制法律效力,違反了也難以追究。中小企業可以視這項設定為表達「立場」的手段,而非百分之百的技術保障。真正有效的內容保護,仍需要搭配版權聲明、資料授權條款等其他措施一起考量。
資料來源
- AI Weekly: OpenAI, Google, Microsoft, Anthropic Back One AI Opt-Out Token
- Cellcog: OpenAI, Google, Microsoft Back One AI Training Opt-Out: robots.txt Rules and 2027 Deadlines
- Monster Megs: What The Shared AI Training Control Means
- Nagesh Polu Blog: OpenAI, Google and Microsoft Back One AI Training Opt-Out
- Taipei Times: More than half of Taiwanese use AI tools, survey says
想知道公司哪些工作可以交給 AI?
台灣人工智慧網路(Ai.com.tw)提供免費 AI 企業健診、老闆 AI 經營講座、企業 AI 內訓與 AI 員工系統建置,以及一站式的 AI 管理系統-管理王,協助企業把 AI 真正用進日常工作。
免付費電話:0800-003-191 | LINE ID:@119m