2026 年 9 月到 10 月,三家 AI 大廠在一個多月內接連推出旗艦模型:OpenAI 在 9 月 3 日發表 GPT-6 Astra,Anthropic 在 9 月 22 日推出 Claude Opus 5.5,Google 則在 9 月 30 日發表 Gemini 4 Argon,並於 10 月 13 日與 14 日開放給開發者與 Google Cloud 企業客戶。三款模型的上下文長度都來到約 100 萬 token,評測分數也彼此接近,但 API 價格最多相差 2.5 倍,開放管道與資料政策也各有不同。這篇 AI 模型比較不重複介紹單一模型,而是站在企業採購與導入的角度,依三家官方公布的規格、價格與條款,整理一張對照表、一張依用途推薦表與三個成本試算,再給台灣企業 5 個選模型的判斷標準。結論先講:沒有一款模型在所有工作都最好,企業最穩的做法是用自己的資料小量實測,並保留隨時切換模型的彈性。
AI 模型比較:三家旗艦模型 2026 年各自定位是什麼?
在比較數字之前,先看三家廠商怎麼描述自己的旗艦模型,因為定位會直接影響它擅長的工作類型。
Google 把 Gemini 4 Argon 定位為「真實世界深度工作」的前沿模型,強調長時間、多步驟的推理,例如大型程式改寫、財務與法律研究,以及防禦型資安工作。它最特別的地方是輸出上限可以拉到約 105 萬 token,並且能直接讀取影片與音訊。想了解 Argon 本身的完整規格、評測與開放時程,可以參考本站的 Gemini 4 Argon 完整解析,本文不再重複。
Anthropic 在官方模型總覽中,把 Claude Opus 5.5 列為「多數工作負載建議的起點」,用途是長時間執行的代理式程式開發與知識工作。官方公告也表示,Opus 5.5 在多數工作上的表現與更高階的 Claude Fable 5.1 相當,但價格低很多,典型工作負載的成本比前一代 Opus 5 低約 40%。本站也有一篇 Claude Opus 5.5 發表解析 可以延伸閱讀。
OpenAI 的 GPT-6 Astra 主打長時程的代理工作,包括電腦操作、程式開發、研究與多步驟任務。據媒體報導,它是 OpenAI 第一個在自家準備度框架中被評為資安「Critical」等級的模型,因此採分階段開放,先給 Daybreak 計畫的企業客戶,再逐步擴大到 ChatGPT 付費方案與 API。
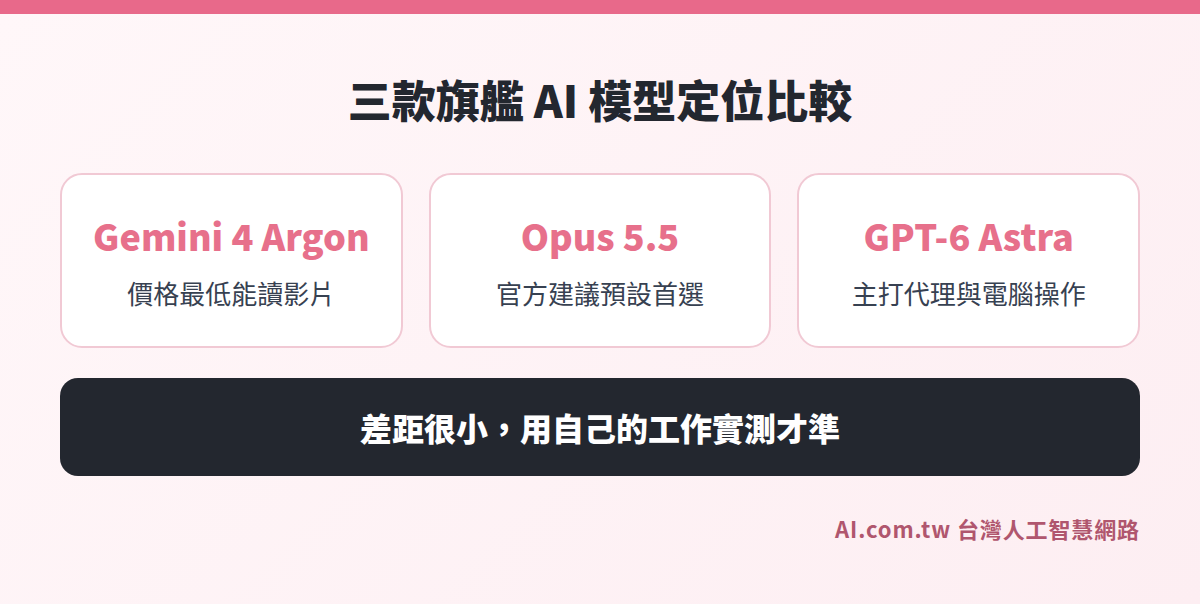
一句話看懂這場 AI 模型比較
Argon 價格最低且能讀影片,Opus 5.5 在官方建議中是企業日常工作的預設首選,GPT-6 Astra 單價最高但在電腦操作與代理任務上被官方強調,三者差距小到必須用自己的工作實測才分得出高下。
三家規格與價格怎麼比?AI 模型比較對照表
下表依 Google 開發者文件與官方部落格、Anthropic 模型總覽與價格頁、OpenAI 開發者文件與價格頁整理,價格皆為每 100 萬 token 的美元原價,新台幣以 1 美元約 32 元粗估。
| 項目 | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 發布日期 | 2026 年 9 月 30 日發表,10 月 13 日起開放開發者 | 2026 年 9 月 22 日 | 2026 年 9 月 3 日,分階段開放 |
| API 模型代號 | gemini-4-argon | claude-opus-5-5 | gpt-6-astra |
| 上下文長度 | 1,048,576 token(輸入與輸出共用) | 100 萬 token | 1,050,000 token(輸入最多 922,000) |
| 單次輸出上限 | 預設 65,536,長篇輸出模式最高約 105 萬 | 128,000(批次 API 搭配測試參數可達 30 萬) | 128,000 |
| 輸入格式 | 文字、圖片、影片、音訊、PDF | 文字、圖片 | 文字、圖片 |
| 輸入價格 | 優惠期 2 美元(約 64 元),12 月起 4 美元 | 4 美元(約 128 元) | 10 美元(約 320 元) |
| 輸出價格 | 優惠期 10 美元(約 320 元),12 月起 20 美元 | 20 美元(約 640 元) | 50 美元(約 1,600 元) |
| 快取輸入 | 輸入價的 5%(折扣 95%) | 0.20 美元(輸入價的 5%) | 1 美元 |
| 長上下文加價 | 官方公告未提及分級加價 | 無,100 萬 token 內同一單價 | 輸入超過 272K 時,輸入 2 倍、輸出 1.5 倍 |
| 批次處理 | 支援 Batch API 與 Flex | 批次 5 折(2 美元/10 美元) | Batch 與 Flex 皆 5 折 |
從表格可以看出三個重點。第一,三家的上下文長度已經拉到同一個量級,「能不能一次讀完整份文件」不再是主要差異。第二,價格差距很明顯:在 Argon 優惠期內,Argon 的單價只有 GPT-6 Astra 的五分之一;12 月起 Argon 恢復正式價後,與 Opus 5.5 的定價相同,都是輸入 4 美元、輸出 20 美元,仍是 GPT-6 Astra 的五分之二。第三,Argon 是三者中唯一官方列出可直接輸入影片與音訊的模型,若工作內容大量涉及會議錄影或影音素材,這會是實際差異。
開放管道、企業方案與資料政策怎麼比?
除了 API 價格,企業更在意「從哪裡買、合約怎麼簽、資料會不會被拿去訓練」。以下依官方條款與公告整理。
| 項目 | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 員工使用的介面 | Gemini app(AI Pro、Ultra)、Gemini for business | Claude Pro、Max、Team、Enterprise | ChatGPT Plus、Pro、Business、Enterprise |
| 開發者 API | Gemini API、Google AI Studio、Google Antigravity | Claude Platform | OpenAI API、Codex |
| 雲端平台 | Google Cloud 的 Gemini platform | Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS | 媒體報導提及 AWS,各雲端細節以官方為準 |
| 資料不訓練政策 | Gemini API 付費服務不使用提示與回應改進產品;免費服務可能會使用 | 商業條款明訂 Anthropic 不得以客戶內容訓練模型 | API 資料預設不用於訓練,除非客戶主動選擇分享 |
| 資料保留與駐留 | 付費服務仍會在有限期間記錄,用於偵測濫用 | 支援零資料保留;指定美國境內推論價格乘以 1.1 | 濫用監控日誌預設最多保留 30 天;零資料保留需申請;資料駐留端點加價 10% |
| 企業版價格 | 官方尚未公布統一價格,依方案與合約 | 官方尚未公布統一價格,依方案與合約 | 官方尚未公布統一價格,依方案與合約 |
這裡有一個常被忽略的細節:Google 的條款把「免費」與「付費」服務分得很清楚。員工如果用個人帳號在免費的 AI Studio 貼上公司資料,提示與回應可能被用來改進產品,也可能經人工審閱;要連結到有啟用計費的 Cloud 專案或 Workspace 企業帳號,才適用付費服務的資料條款。同樣的道理也適用其他兩家:個人免費帳號與企業合約的資料處理方式不同,企業導入時應統一使用公司帳號。
評測分數可以相信嗎?Gemini 4 Argon 比較時要注意什麼?
很多比較文章會直接拿評測分數排名,但企業選模型時,要先知道這些分數是誰測的、測的是什麼。
同一份評測,各家都說自己領先
以長時間軟體工程任務的 DeepSWE v1.1 為例,Google 在發表 Argon 時公布的數據是 Argon 77.9%、Claude Opus 5.5 74.2%、GPT-6 Astra 74.1%。這組數字由 Google 自行公布,並經 9to5Google 等媒體引述。另一方面,Anthropic 在 Opus 5.5 的公告中列出的 Terminal-Bench 4.0 是 Opus 5.5 66.4%、GPT-6 Astra 57.9%;但在同一張表的 AutomationBench 上,GPT-6 Astra 是 41.4%,略高於 Opus 5.5 的 40.0%。Google 則表示 Argon 在 AutomationBench 拿到 51.3% 排名第一。
把這些數字放在一起看,會發現每家都選擇自己表現好的評測放在公告前面,而且不同廠商的測試設定、思考等級與工具組合也不一定一致,數字不能直接橫向相加比較。
| 評測 | 公布者 | 結果 | 解讀 |
|---|---|---|---|
| DeepSWE v1.1 | Argon 77.9%、Opus 5.5 74.2%、GPT-6 Astra 74.1% | 三者差距約 4 個百分點以內 | |
| Terminal-Bench 4.0 | Anthropic | Opus 5.5 66.4%、GPT-6 Astra 57.9% | Anthropic 表格未列 Argon |
| AutomationBench | Anthropic、Google | Opus 5.5 40.0%、GPT-6 Astra 41.4%;Google 稱 Argon 51.3% | 不同廠商公布,設定可能不同 |
| CWE-bench v1(資安) | Argon 68%,與其他模型並列第一 | 資安能力已是各家旗艦的共同重點 |
企業該怎麼看待評測分數?
我們的建議是把公開評測當作「入圍名單」,而不是「最後答案」。差距在幾個百分點之內的模型,放到你公司的實際工作上,排名很可能會翻轉。真正會影響成果的,往往是繁體中文的用詞是否自然、能不能照公司格式輸出、會不會亂編數字,而這些都沒有公開評測可以告訴你。
同一個任務三家要花多少錢?成本試算
以下用三個常見的企業情境試算,幫助你感受價格差距。試算假設如下:三家處理相同內容時的 token 數相同(實際上各家的斷詞方式不同,同一段中文換算出的 token 數會有差異,Anthropic 文件也提醒新版斷詞器的 token 數會比舊模型多);不計快取與批次折扣;新台幣以 1 美元約 32 元計算;價格採官方標準價。
| 情境與假設 | Gemini 4 Argon(優惠期/正式價) | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 審閱一份 50 頁合約:輸入 3 萬 token、輸出 3,000 token | 0.09 美元/0.18 美元(約 3 元/6 元) | 0.18 美元(約 6 元) | 0.45 美元(約 14 元) |
| 客服草稿每月 3 萬則:每則輸入 2,000、輸出 500 token | 270 美元/540 美元(約 8,640 元/17,280 元) | 540 美元(約 17,280 元) | 1,350 美元(約 43,200 元) |
| 一次分析 40 萬 token 的年報與附件,輸出 1 萬 token | 0.9 美元/1.8 美元(約 29 元/58 元) | 1.8 美元(約 58 元) | 8.75 美元(約 280 元,已超過 272K 適用長上下文價) |
這張表有幾個值得注意的地方。
- 單次任務的費用其實都很低,審一份合約最多十幾元新台幣,比起人工審閱的時間成本微不足道。真正會拉開差距的是「大量、重複」的工作,例如每月數萬則的客服或分類。
- GPT-6 Astra 在超長文件上的成本差距會被放大,因為輸入超過 272K token 時,整個請求的輸入單價變 2 倍、輸出變 1.5 倍。若你的工作經常一次丟入數十萬 token 的資料,這點要特別估算。
- Argon 的優惠價只到 2026 年 11 月 30 日,之後單價變兩倍。企業若在優惠期間做測試,編列正式預算時要用正式價計算。
- 客服、分類這類大量日常工作,其實不一定要用旗艦模型。以 Anthropic 為例,官方價格頁列出的 Claude Sonnet 5.5 是輸入 2 美元、輸出 10 美元,Haiku 5.5 更從輸入 0.10 美元起,其他兩家也都有較輕量的模型可以選擇。
依用途怎麼選?企業 AI 模型推薦表
綜合官方定位、公開評測與規格限制,我們整理出以下依用途的優先試用建議。請注意這是「先從哪一款測起」的建議,不是最終結論,每一項都應該用自己的資料驗證。
| 用途 | 優先試用 | 理由(依官方資料) | 提醒 |
|---|---|---|---|
| 寫程式與大型程式改寫 | Gemini 4 Argon、Claude Opus 5.5 | Argon 在 Google 公布的 DeepSWE v1.1 領先,且單次可輸出極長內容;Opus 5.5 在 Anthropic 公布的 Terminal-Bench 4.0 領先 | 兩者差距小,建議拿自家程式庫實測 |
| 長文件、法務與財務研究 | Claude Opus 5.5、Gemini 4 Argon | 兩者在 100 萬 token 內都不加價;Google 表示 Argon 在財務與法律代理評測領先;Anthropic 公布 Opus 5.5 在 GDPval-AA 知識工作評測最高 | GPT-6 Astra 超過 272K 會加價;重要結論務必人工覆核 |
| 客服與大量日常任務 | 各家的中小型模型 | 旗艦模型單價高,大量任務選輕量模型更划算 | 先用旗艦模型定標準,再測輕量模型能否達到 |
| 多模態與影片分析 | Gemini 4 Argon | 三者中唯一官方列出可輸入影片與音訊 | Opus 5.5 與 GPT-6 Astra 目前官方列出的輸入為文字與圖片 |
| 資安 | 三家都要評估 | Argon 在 CWE-bench v1 並列第一並有 Fairwind 計畫;據報導 GPT-6 Astra 被 OpenAI 評為資安 Critical 等級;Opus 5.5 部署了與 Fable 5.1 相似的資安防護 | 一般企業帳號都有攻擊性任務的限制,防禦工作需走廠商的審核計畫 |
Claude Fable 5.1 等更高階模型值得考慮嗎?
Anthropic 還有一款更高階的 Claude Fable 5.1,官方定位是「高難度推理與長時程代理工作」,價格是輸入 10 美元、輸出 50 美元,與 GPT-6 Astra 相同,是 Opus 5.5 的 2.5 倍。Anthropic 官方建議先用 Opus 5.5,若提高思考等級後仍不夠,再改用 Fable 5.1。對多數台灣企業的日常工作來說,Opus 5.5 這一級已經足夠,Fable 5.1 比較適合研發、複雜分析等少數高價值任務。
企業 AI 模型怎麼選?5 個判斷標準
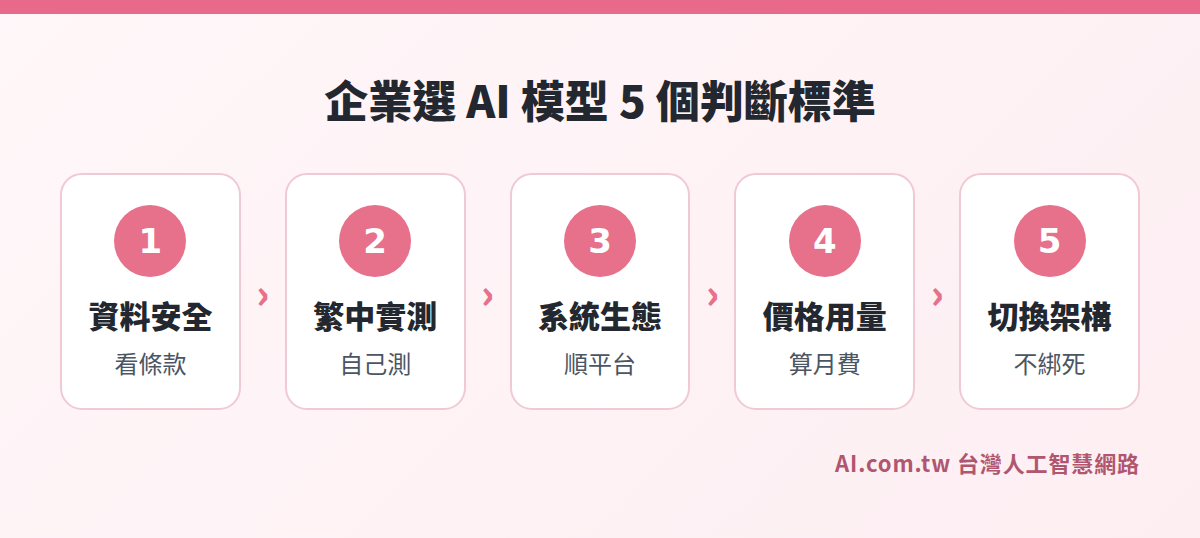
比完規格、評測與價格之後,真正做決定時,我們建議企業用以下 5 個標準逐項檢查。
標準一:資料安全與合約條款
三家的企業與 API 服務都承諾預設不用客戶資料訓練模型,但細節不同:資料保留多久、能不能申請零資料保留、能不能指定資料存放區域、是否另外加價。金融、醫療、法律等受監管產業,應該請法務或資安人員實際讀過條款與資料處理附約,而不是只看行銷頁面。最基本的一步,是禁止員工用個人免費帳號處理公司資料。
標準二:繁體中文表現一定要自己測
目前三家公布的評測幾乎都以英文為主,沒有一份公開數據能告訴你哪一款模型的繁體中文最好。台灣企業最常遇到的問題,是模型混用中國大陸用語、公文格式不對、法規名稱寫錯。這些都必須用你自己的文件、你自己的格式要求去測試,才看得出差別。
標準三:既有系統生態
如果公司主要使用 Google Workspace,員工透過 Gemini for business 使用 Argon 會比較順手;Google Cloud 客戶也可以直接在既有帳號中透過 API 使用 Argon。如果公司主要使用 Microsoft 365 與 Azure,Claude 已可在 Microsoft Foundry 部署,OpenAI 與微軟也長期合作,但 GPT-6 Astra 在 Azure 的開放細節請以官方為準。已經在 AWS 上的企業,則可以從 Amazon Bedrock 等管道接入。順著既有生態選擇,可以減少帳號、權限與帳單管理的成本。
標準四:價格與用量
不要只比單價,要用「每月實際用量」去算。一個每月只用幾百次的法務助理,選最貴的模型可能一個月也才幾百元;但每月數萬次的客服或文件分類,模型選擇會直接影響一年數十萬元的預算。另外也要把快取、批次處理這些省錢機制算進去,三家都提供批次 5 折,而重複使用的系統提示透過快取可以大幅降低輸入費用。
標準五:可以切換多模型的架構
這是我們最想強調的一點。三家旗艦模型在一個多月內輪流發表、輪流宣稱領先,價格也每隔幾個月就調整一次。如果把系統綁死在單一模型,下一次換代時就只能被動接受。比較好的做法是在系統中保留一層「模型切換」,讓不同任務可以接不同模型,例如程式改寫用 A、客服用 B、影片分析用 C,日後也能依價格與表現隨時調整。
台灣中小企業怎麼開始比較 AI 模型?
對中小企業來說,不需要一開始就做大型評估專案。以下是我們建議的實測方法,通常一到兩週就能得到可以做決定的結果。
- 挑一份真實工作:選一件每週都在做、耗時又重複的工作,例如業務每週的客戶拜訪紀錄整理、會計的月報差異說明、人資的職缺說明撰寫。
- 準備同一組輸入:把相同的資料與相同的指令,分別交給三家模型。
- 每家各跑 20 次:同一份工作在三家各跑 20 次,看的不只是最好的一次,而是品質穩不穩定、會不會偶爾出錯。
- 請實際使用者評分:由負責這項工作的同仁評分,項目可以包括正確性、繁體中文用語、格式是否符合、需要修改的時間。
- 記錄成本與速度:把每次的 token 用量與等待時間記下來,換算成每月預估費用。
用這個方法,常見的結果是:不同部門最後選的模型不一樣。例如法務可能偏好長文件審閱穩定的模型,行銷可能偏好文字風格比較自然的模型,需要分析產品影片或教學影片的部門則會選擇能直接讀影片的模型。這正好說明「不要綁單一模型」的重要性。
如果公司內部還不確定從哪一件工作開始測、或不知道怎麼設計評分表,可以先透過免費的 AI 企業健診 盤點適合導入的流程;若希望讓各部門同仁學會自己設計測試、寫出穩定的指令,也可以安排 企業 AI 內訓,用公司自己的工作當作上課教材。測出結果之後,再把常用流程整合進 管理王 AI 系統 等內部系統,讓模型切換與權限管理都集中處理。
常見問題
Gemini 4 Argon、Claude Opus 5.5、GPT-6 Astra 哪一個最好?
沒有一款在所有工作都最好。依各家自行公布的評測,Argon 在 DeepSWE v1.1 領先,Opus 5.5 在 Terminal-Bench 4.0 領先,GPT-6 Astra 在部分代理與電腦操作評測表現突出,差距多在幾個百分點之內。企業應該用自己的工作實測,而不是只看排行榜。
三家旗艦模型哪一家 API 最便宜?
以官方標準價來看,Gemini 4 Argon 在優惠期(至 2026 年 11 月 30 日)每 100 萬 token 輸入 2 美元、輸出 10 美元,是三者最低;優惠期後與 Claude Opus 5.5 同為 4 美元與 20 美元。GPT-6 Astra 為 10 美元與 50 美元,且輸入超過 272K token 會再加價。
公司資料丟進這些模型會被拿去訓練嗎?
依三家官方條款,企業與 API 付費服務預設都不會用客戶資料訓練模型。但個人免費帳號的規則不同,例如 Google 的免費服務可能使用內容改進產品並經人工審閱。企業應統一使用公司帳號,並確認資料保留期限與存放區域。
中小企業一定要用旗艦模型嗎?
不一定。旗艦模型適合複雜推理、長文件與程式改寫;客服回覆、資料分類、簡單摘要等大量日常工作,用各家的中小型模型通常就夠,成本可以降低數倍。建議先用旗艦模型建立品質標準,再測試輕量模型能否達到。
為什麼建議不要只綁定單一 AI 模型?
因為模型更新與降價的速度非常快,光是 2026 年 9 月就有三款旗艦模型接連發表。保留可切換多模型的架構,可以讓不同任務使用最適合的模型,也能在價格或表現改變時快速調整,避免被單一廠商綁住。
資料來源
- Google 官方部落格:Gemini 4 Argon: our next era of frontier intelligence
- Google 官方部落格:Introducing Gemini 4 Argon
- Google AI 開發者文件:Gemini 4 Argon
- Google Cloud 部落格:Gemini 4 Argon available on Google Cloud
- Gemini API 服務條款
- 9to5Google:Google announces Gemini 4 Argon as its new frontier model
- Anthropic 官方公告:Claude Opus 5.5
- Anthropic 開發者文件:Models overview
- Anthropic 開發者文件:Pricing
- Anthropic:Commercial Terms of Service
- OpenAI 開發者文件:GPT-6 Astra
- OpenAI 開發者文件:Pricing
- OpenAI 開發者文件:Data controls in the OpenAI platform
- Constellation Research:OpenAI launches GPT-6 Astra
想知道公司哪些工作可以交給 AI?
台灣人工智慧網路(Ai.com.tw)提供免費 AI 企業健診、老闆 AI 經營講座、企業 AI 內訓與 AI 員工系統建置,以及一站式的 AI 管理系統-管理王,協助企業把 AI 真正用進日常工作。
免付費電話:0800-003-191 | LINE ID:@119m